Jev 完全指南:为更快决策而生的前沿 AI
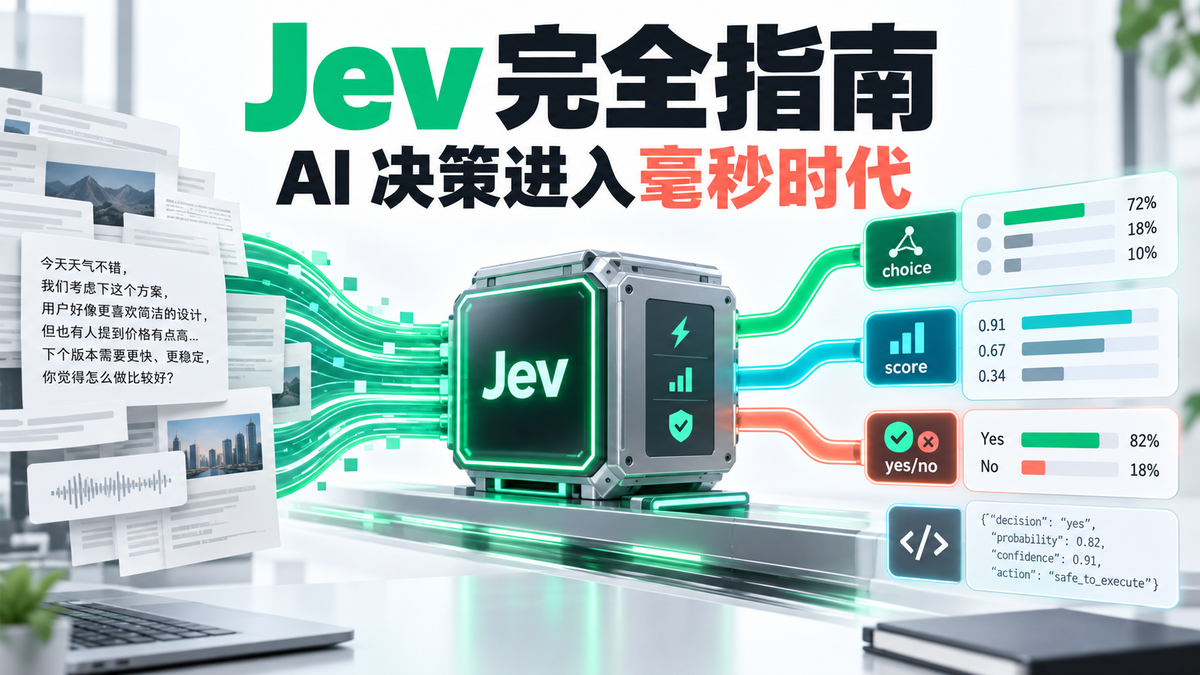
Jev 不生成长文本,而以 70–500 毫秒返回类型安全、带校准置信度的结构化决策。本文详解 System One、三种问题类型、级联架构、案例与限制。
编者说明:本文根据 unicodeveloper 发表于 Medium 的文章 《The Ultimate Guide to Jev: The new Frontier AI for faster decisions》翻译、整理,并结合 Jev 当前官方资料核对关键数据。原文发表于 2026 年 9 月 17 日,观点与案例归原作者及相关项目作者所有。
快速答案:Jev 是 TypeSafe AI 推出的“System One”模型。它不生成长文本,而是接收程序状态和类型化问题,在一次并行计算中返回 Choice、Score 或 Noul 等结构化概率决策。官方宣称端到端延迟约为 70–500 毫秒,输出 token 免费,而且结果不会超出预先定义的类型空间。
价格更新(2026 年 9 月 27 日):原文和部分官方本地化页面仍写每百万输入 token 0.042 美元;Jev 当前英文官网显示为 0.084 美元。本文保留原文发布时的数字,同时以当前官网价格为准。

Jev 究竟解决什么问题?
你有一个能理解语言的模型,但真正需要的只是一个让代码可以分支执行的决定。传统做法通常是先让模型生成自然语言,再写第二套程序把决定从自然语言里“抠”出来。
你会提示模型“只返回有效 JSON”,然后解析、校验;发现它把对象包在 Markdown 代码块里,就再处理一次;它把枚举值 technical 写成 technical support,就需要重试;它没有回答而是先道歉,又要准备兜底逻辑。

第二套程序并不小。在许多生产 AI 系统中,它占据了相当一部分代码,也制造了大多数不稳定性。TypeSafe AI 创始人 Diogo Almeida 曾说,他在 OpenAI 参与了让语言模型更善于遵循指令和与人交流的方法,这些研究后来成为 ChatGPT 的基础;但他逐渐意识到,仅靠聊天模型通往 AGI 还缺少一个重要部分。
于是,这位曾帮助模型学会“与人说话”的研究者,花了两年时间打造一个只与软件“说话”的模型。
什么是 System One 模型?
System One 模型是一类为软件直接使用而设计的 AI:它快速做出结构化判断,返回类型化的值和经过校准的概率,而不是生成自由文本。
心理学中的 System 2 是缓慢、审慎的推理;System 1 则是你还没读完整句话就已经形成的快速判断。LLM 逐 token 生成答案,代码随后再解析、校验和重试;Jev 则同时评估所有问题,直接返回已经合法的值。

几乎所有前沿实验室都在争相强化 System 2,但现实软件里的大量决策其实属于 System 1。我们过去一直为这些简单、高频、答案空间明确的判断支付 System 2 的成本。
区别不只是模型大小。LLM 的答案逐 token 生成,因此延迟随输出长度增长,最终得到的字符串理论上可以是任何内容。Jev 接收状态和全部问题,一次并行计算后,从开发者预先定义的答案空间中返回类型化结果。
Jev 这个名字致敬经济学家 William Stanley Jevons。杰文斯悖论认为,当某种资源的使用效率大幅提高、价格显著下降时,人们往往会使用得更多。TypeSafe AI 的判断是:当智能成本下降到原来的两百分之一,它不只是打折后的旧产品,而会让一整类过去不值得自动化的决策变得可自动化。
Jev 与前沿 LLM 的区别

Jev 放弃了文本生成,换来更快的响应、固定的输出类型和可用于系统控制的置信度。它适合分类、路由、评分、过滤与门控;LLM 则适合写作、解释、复杂推理、代码生成和开放式对话。
因此,Jev 并不是“更小、更便宜的 Claude 或 GPT”。它更像一个带有前沿语言理解能力的智能函数调用,或者一个能理解模糊语义的 if 语句。
如何使用 Jev?
一次调用包含一个 state,也就是待判断的内容,以及一组问题。Jev 提供三种问题类型:
- Choice:从你定义的选项中选一个,最多 255 个选项。
- Score:按照 2–10 个用自然语言描述的有序等级给状态评分,并允许返回等级之间的位置。
- Noul:回答一个是/否问题,返回“是”为真的概率。

下面是一个客服工单分流示例。三项判断只需一次往返,原文称大约 400 毫秒:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()
ticket = (
    "Hi, I've been trying to connect my Stripe account for 3 days "
    "and it keeps failing. I'm losing sales. Please help ASAP."
)

response = client.system_one(
    state=ticket,
    questions={
        "department": Choice(
            instructions="Which team should handle this",
            criteria={
                "billing": "Payment or subscription issues",
                "technical": "Bugs or integration problems",
                "sales": "Pricing or account questions",
            },
        ),
        "frustration": Score(
            instructions="How frustrated the customer appears",
            criteria=[
                "Calm, just stating facts",
                "Frustrated but civil",
                "Very angry, strong language",
            ],
        ),
        "is_urgent": Noul(
            instructions="The message conveys urgency or time-sensitivity"
        ),
    },
)

print(response.answers["department"].choice)   # "technical"
print(response.answers["frustration"].score)   # 1.035
print(response.answers["is_urgent"].noul)      # 0.999
这里没有“请务必只输出 JSON”之类的格式提示,也不需要把 json.loads 包进异常处理。Score 返回的是在你定义的刻度上的位置,而不是简单标签,所以 1.035 表示它略高于第二档。Choice 和 Score 还会同时返回完整概率分布和 confidence。
原文还给出了 Valyu 深度检索与 Jev 结合的临床研究例子:Valyu 先从 PubMed 与 arXiv 检索 GLP-1 受体激动剂和心血管结局相关论文;Jev 再为每篇论文判断它是否为随机对照试验、是否报告 MACE,并对因果证据强度评分。只有超过设定阈值的论文进入短名单。这里,检索负责找资料,Jev 负责做有边界的判断。
为什么“校准后的置信度”会改变系统设计?
Jev 不只返回答案,还返回一个说明答案应被信任到什么程度的数字。答案告诉你“是什么”,置信度告诉你“是否应该行动”。对整个系统只设一个统一阈值,是常见错误。

TypeSafe 把其训练方法称为 Reinforcement Learning for Calibrated Decisions(RLCD)。RLHF 优化人类偏好,容易得到听起来很有把握的回答;RLCD 则把概率与实际结果对齐。理想情况下,一组置信度为 0.9 的预测,长期统计上应有约 90% 正确。
action = response.answers["intent"]

if action.confidence < 0.5:
    route_to_human(user_message)
elif action.choice == "check_balance":
    show_balance(account_id)
elif action.choice == "approve_transfer":
    if action.confidence > 0.85:
        confirm_then_execute(account_id)
    else:
        ask_user_to_confirm(account_id)
这里没有单一阈值。打开错误页面可能只浪费用户三秒,错误批准转账却会造成资金损失。错误后果越严重,无人监督自动执行的门槛就应越高。这个门槛存在于代码里,是可测量、可回滚的产品决策,而不是藏在提示词里的模糊愿望。
需要注意,校准描述的是一组预测的统计性质,不保证每个单独答案都正确。置信度 0.95 仍然可能错。它提供的是一个在整体上表现可预测的控制旋钮,而不是对单次判断的承诺。
什么时候应该用 Jev,什么时候继续用 LLM?
当答案空间已知且有边界、吞吐量或延迟是主要约束,或者你需要用校准置信度来控制动作时,适合使用 Jev。当任务需要生成文字、做算术、解释原因或进行开放式推理时,应使用 LLM。

Jev 并不是在和 Opus 5 或 GPT-5.6 争夺同一个位置。它真正替代的是“用廉价 LLM 加几百行解析代码拼出来的分类器”,以及那些因为经济账不成立而从未被自动化的判断。不要掉进“一种模型解决所有问题”的陷阱。
最划算的架构:级联

Jev 不是前沿 LLM 的替代品,而是决定哪些请求值得调用前沿 LLM 的那一层。最有意思的架构不是“替换你的 LLM”,而是把 Jev 放在快速、便宜、可校准的入口位置。
多数请求经 Jev 分类后可由普通代码直接处理;一部分路由给带有正确上下文的专用模型;真正困难、昂贵的少数任务,才交给前沿模型或人工。
原文以 100 万张客服工单计算:全部交给前沿模型、按每单约 0.03 美元估算,总成本约 30,400 美元;级联架构为每张工单先支付约 0.0004 美元,只让 20% 进入前沿模型,总成本约 6,480 美元。更值得注意的是响应时间:约 80 万张工单能在半秒内完成判断,而不是等待十秒。
级联比例由置信度阈值决定。阈值写在代码中,可以回滚,也可以根据“升级请求后来是否真的有必要”持续衡量。团队无需重新训练模型,就能调整系统行为。
已经有人用 Jev 构建了什么?
以下项目都来自发布后的头几天,应被视为发布周实验,而不是成熟生产案例。数据大多由作者自行报告,但它们很好地展示了 Jev 适合的问题形态。
1. 用 8 美分分类 1,018 篇研究论文
1kpapers.com 由 Hassan El Mghari 制作,用 Jev 批量判断研究论文。它展示了高吞吐、答案空间明确的语义分类为什么适合 System One 模型。
2. 7 秒完成机票预订的浏览器智能体
browser-use/jev-ultrafast 在真实 Google Flights 上完成苏黎世到伦敦的预订流程,作者报告用时 7.1 秒、成本 0.0039 美元,包含文本生成和页面加载。它同时询问 click、type 和 select 等候选目标,最后只执行与选中操作匹配的那个:两个决策,只需一次网络调用。
3. 每一步成本不到半美分的 Computer Use
awlevin/typesafe-computer-use 读取 Mac 屏幕上的 OCR 结果,让 Jev 选择下一步动作;只有遇到真正需要自由文本的输入框时,才调用写作模型。作者报告 Jev 每次决策约 0.0002 美元,12 步任务约 0.003 美元,模型延迟 0.13–0.38 秒;对比中,直接把截图交给 Claude Opus 5 的每次决策约 0.032 美元。
代价也很明确:前沿模型顺手完成的日期理解、空间推断等能力,需要在 Jev 流程周围被重建为确定性状态。
4. 每个区块都做决策的做市程序
jarrodwatts/jev-trader 把 Jev 用在区块链做市场景中。它代表的是另一类高频判断:允许的行动集合明确,但每个区块的状态都在变化。
5. 以 2.5Hz 做战术判断的自主无人机
RomanSlack/jev-drone 让四旋翼在 MuJoCo 中只用机载相机飞过五站障碍路线。这个项目最值得学习之处,是它非常清楚地限制了 Jev 的职责:
- 500Hz 几何飞控:普通代码;
- 50Hz 导航与安全反射:普通代码,始终掌握安全;
- 15Hz 相机到符号场景:传统计算机视觉;
- 约 2.5Hz 战术判断:Jev,仅提供建议。
计算机视觉先把深度和分割结果压缩成五个前向距离区域、障碍高度与目标方位。Jev 再一次回答三个问题:动作 Choice、风险 Score,以及目标是真的丢失还是暂时遮挡的 Noul。项目 README 说得很清楚:Jev 不能做感知层,也不能以控制频率运行。
6. 从内存而不是像素玩《超级马里奥》
fhshaik/typesafe-mario 是一个 NES 控制实验,Jev 从七种合法动作中选择一个。模型从不看截图;运行框架把模拟器遥测和 RAM 转换成紧凑、以对象为中心的 JSON,包括马里奥的运动、跳跃轨迹、即将出现的敌人、地形、响应延迟和最近动作结果。
它展示了 Jev 强迫开发者遵守的一种纪律:在提出判断问题之前,你必须先决定“状态究竟是什么”。
其他值得关注的项目
- phyous/tsai-sc 让 Jev 完成《星际争霸》共享版的第一个战斗任务 Strongarm,共做出 421 次模型决策,并发布验证报告。
- TypeSafe Typewriter 会随着输入实时更新 16 个类型化判断,是体验亚秒级结构化判断最直观的演示之一。
所有这些案例都有同一个模式:循环、安全机制和算术留在普通代码里,只把代码难以表达的狭窄判断交给 Jev。
粗糙边缘与安全限制
TypeSafe 在“jaggedness”页面中公开了 Jev 的已知缺点。它会按字面理解指令,回答你真正写下的问题,而不是你心里想问的问题;当状态中塞入与问题无关的材料时,准确率会下降;它也不会自动把 state 当成可能具有敌意的输入,因此,专门为影响分类结果而设计的文本可能改变答案。
如果 state 含有用户可控内容,抵御提示注入、数据投毒和策略绕过仍是应用开发者的责任。Jev 可以保证输出类型合法,却不能保证合法值一定正确,更不能替代权限检查、交易确认、安全联锁或人工审批。
一个必须认真对待的发现

TypeSafe 的评测显示,每个模型放进结构化工作流后,成绩都比用同一政策写成单个提示更好。Haiku 4.5 从单提示的 18.1% 提升到工作流中的 53.6%;Opus 5 从 64.8% 提升到 73.1%。这些是厂商发布的评测数据,应结合任务和测试设置理解。
即使你暂时不用 Jev,这个结论仍然重要:把任务拆成狭窄、类型明确的判断,会改善你已经在付费使用的模型。系统设计通常比换一个更强模型更能决定最终可靠性。
常见问题
Jev 是什么?
Jev 是 TypeSafe AI 推出的 System One 模型。它接收程序状态和类型化问题,用一次并行计算返回结构化概率决策,而不是生成自由文本。
谁创建了 Jev?
TypeSafe AI 于 2024 年在旧金山成立,创始团队包括 CEO Diogo Almeida、COO Sasha Sheng 和 CTO Erik Gafni。原文称 Almeida 曾参与 RLHF、InstructGPT、ChatGPT 和 GPT-4 相关工作。
Jev 多少钱?
原文发布时写的是每百万输入 token 0.042 美元,输出免费。2026 年 9 月 27 日,Jev 当前英文官网显示为每百万输入 token 0.084 美元,输出仍免费。价格可能继续变化,使用前应查看官方页面。
Jev 比 GPT-5.6 或 Claude Opus 5 更快吗?
在 TypeSafe 自己的 System One 任务基准中,Jev 明显更快。原文列出每个案例约 0.4 秒,而 GPT-5.6 Terra 为 10.1 秒、Sol 为 23.3 秒、Opus 5 为 37.8 秒。这些是厂商自报数据,并未在相同条件下得到广泛独立复现。
Jev 会产生幻觉吗?
它不能返回你定义的 schema 之外的值,这是架构保证;但它仍可能返回错误的合法值。“零类型错误”不等于“零判断错误”。
Jev 能写文章、代码或摘要吗?
不能。它不是为生成文本而训练的。生成内容应交给 LLM,Jev 更适合决定如何处理这些内容。
Choice、Score 和 Noul 分别是什么?
Choice 从最多 255 个选项中选一个;Score 按 2–10 个有序等级评分,并可返回等级之间的位置;Noul 返回一个是/否命题为真的概率。
应该用 Jev 替换现有 LLM 吗?
不应该。更有效的模式是级联:Jev 在入口便宜地分类与路由,普通代码处理确定性部分,前沿模型或人工负责少数真正困难的任务。
来源与延伸阅读: